Ich wollte eine einfache Frage beantworten: Welches LLM ist gerade wirklich das beste für Coding?
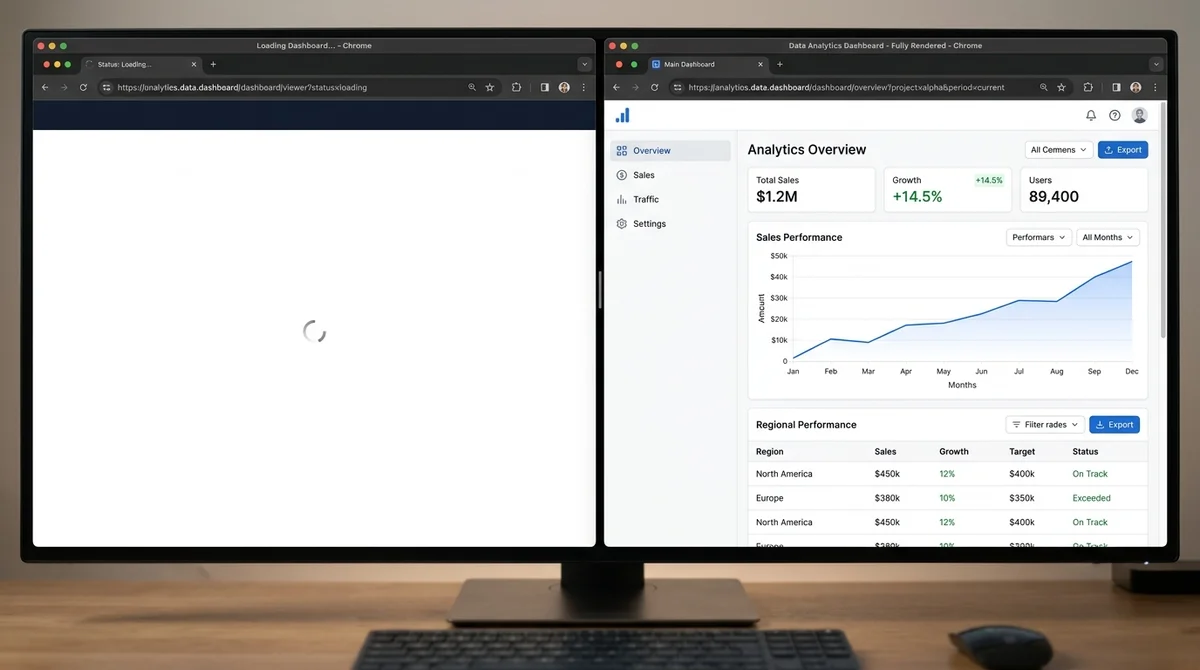
Also habe ich Claude gebeten, die aktuellen Benchmark-Daten von LiveBench, LiveCodeBench und Chatbot Arena zu holen. Die Ergebnisse kamen leer zurück. Nicht weil die Daten nicht existieren, sondern weil diese Seiten Single-Page-Applikationen sind, die alles clientseitig mit JavaScript rendern. KI-Crawler, einschliesslich desjenigen, der genau diese Konversation antreibt, können kein JavaScript ausführen. Sie rufen das rohe HTML ab, finden ein leeres div, und gehen weiter.
Die Ironie ist kaum zu übertreffen. Die Seiten, die KI-Modelle bewerten, sind für KI unsichtbar.
Das SPA-Problem in 30 Sekunden
Eine Single-Page-Applikation (SPA) lädt eine leere HTML-Hülle, dann baut JavaScript die gesamte Seite im Browser auf. Für Menschen funktioniert das einwandfrei. Googles Crawler kommt damit auch zurecht, da Googlebot eine vollständige Headless-Chrome-Instanz betreibt.
Aber GPTBot, ClaudeBot, PerplexityBot und alle anderen KI-Crawler führen kein JavaScript aus. Eine Analyse von über 500 Millionen GPTBot-Anfragen fand keinerlei Hinweise auf JavaScript-Ausführung. Wenn diese Crawler LiveBench oder das Arena-Leaderboard besuchen, sehen sie nichts.
Server-Side Rendering (SSR) löst das Problem, indem das vollständige HTML auf dem Server aufgebaut wird, bevor es an den Browser gesendet wird. Der Inhalt ist bereits in der initialen Antwort enthalten. Jeder Crawler, jedes KI-Modell und jede Suchmaschine kann ihn sofort lesen.
Was ich gebaut habe
Ich habe einen Benchmark-Aggregator gebaut, der drei Dinge anders macht.
Erstens nutzt er Headless Chromium via Playwright, um die JS-gerenderten Leaderboard-Seiten nach einem Zeitplan zu crawlen. Der Crawler navigiert zu jeder Seite, wartet bis die Datentabellen gerendert sind, extrahiert die strukturierten Daten und normalisiert sie in ein einheitliches Format.
Zweitens liefert er alles als statisches HTML mit Server-Side Rendering über Next.js aus. Jeder Modellname, jeder Score, jeder Preis steht im rohen HTML-Response. Wenn ein KI-Crawler meine Benchmarks-Seite besucht, bekommt er den kompletten Datensatz, keine leere Hülle.
Drittens stellt er Kosten neben Qualität. Für jedes Modell mit veröffentlichten Kosten pro Aufgabe zeigt die Seite den Score im Verhältnis zu diesen Kosten und markiert die Modelle, die kein anderes Modell in beidem schlägt.
Die Daten werden automatisch zweimal täglich über GitHub Actions aktualisiert. Fehlgeschlagene Crawls überschreiben niemals gute Daten. Ein Sanity-Filter entfernt fehlerhafte Einträge, bevor sie die Seite erreichen.
Was die Daten tatsächlich zeigen (April 2026)
Die Rankings hängen vollständig davon ab, was man misst.
Auf Code Arena (menschliche Präferenz-Votes für Coding-Aufgaben) führt Claude Opus 4.6 mit einem Elo von 1546. Die Top 5 wird von Anthropic-Modellen dominiert.
Auf LiveBench (kontaminationsfreies objektives Scoring) führt GPT-5.4 Thinking mit 80.3%, dicht gefolgt von Gemini 3.1 Pro mit 79.9%. Claude Opus 4.6 fällt auf 76.3%.
Auf LiveCodeBench (kompetitive Programmieraufgaben) verschob sich das Bild erneut: Je nach Schwierigkeitsgrad lagen andere Modelle vorn.
Kein einzelnes Modell gewinnt überall. Das „beste" hängt von der Arbeitslast, dem Budget und der Art der Aufgabe ab. Genau deshalb ist es wichtig, alle Benchmarks nebeneinander zu sehen.
Warum das für Unternehmen relevant ist
Wer KI-Modelle für sein Unternehmen evaluiert, kommt mit einem einzelnen Benchmark oder einem Blog-Vergleich nicht weit. Die Landschaft ändert sich wöchentlich. Modelle, die vor drei Monaten führten, sind heute Mittelfeld. Preise verschieben sich laufend.
Eine live aggregierte Ansicht über mehrere Benchmarks hinweg gibt einem etwas, das keine einzelne Quelle leisten kann. Und weil meine Seite server-gerendert ist, kann man den eigenen KI-Assistenten direkt bitten, sie zu lesen und den aktuellen Stand zusammenzufassen.
Live-Daten ansehen
Meine Benchmarks-Seite ist kostenlos, wird zweimal täglich aktualisiert und ist für Menschen wie KI lesbar: seelig.ai/benchmarks
Brauchen Sie Hilfe bei der Wahl des richtigen Modells für Ihren Anwendungsfall, Ihren Ablauf und Ihr Budget? Genau das mache ich. Schreiben Sie mir.